01
Contexte
Retrouver une information pertinente dans des images, tableaux, PDF et textes demande davantage qu’un index par mots-clés. Le projet, initialement pensé comme le socle technique d’une expérience mobile appelée MAYbe Here, a progressivement été recentré sur le moteur de recherche lui-même — un pipeline capable de croiser plusieurs formes d’information à partir d’une requête textuelle ou visuelle.
02
Architecture multimodale
Le pipeline s’organise en modules indépendants, de l’ingestion des sources jusqu’à la restitution des résultats.
- Ingestion et normalisation de sources hétérogènes
- Stockage persistant dans un Vector Lakehouse
- Embeddings visuels et textuels
- Arbitrage sémantique local
- Recherche hybride multi-passes et scoring de confiance
- API de recherche et interface de démonstration
03
Vector Lakehouse
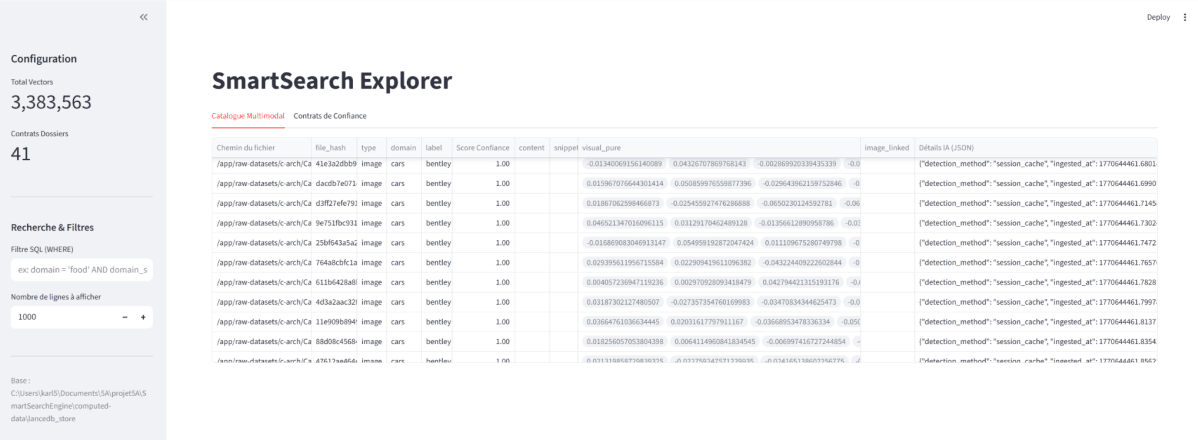
Le stockage repose sur LanceDB et Apache Arrow afin d’unifier vecteurs, métadonnées et données structurées dans une même base persistante. Ce choix remplace une première approche fondée sur des index vectoriels chargés en mémoire, trop dépendante de la RAM pour des volumes importants. Images et textes sont projetés dans un espace vectoriel commun avec CLIP, ce qui permet une recherche par similarité visuelle, textuelle ou combinée.
04
Ingestion multimodale
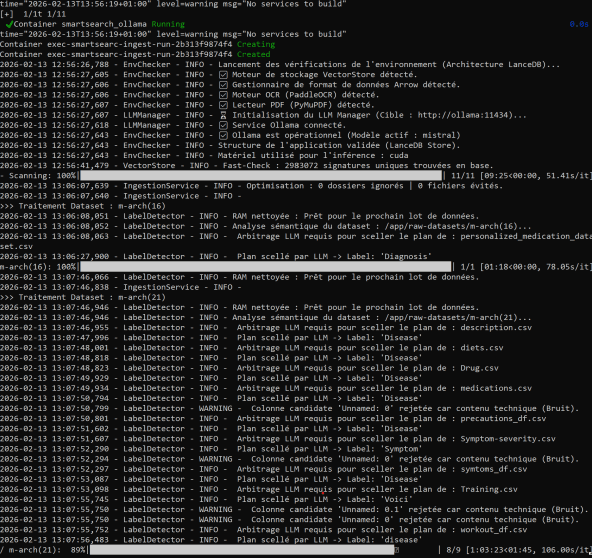
Le moteur accepte plusieurs types de sources — dossiers d’images, CSV et données structurées, PDF et texte brut. Un scanning hiérarchique détecte les changements et limite la ré-indexation aux éléments réellement modifiés ; le traitement est réalisé en streaming et par lots pour maîtriser l’usage mémoire sur des corpus volumineux.
- Détection des changements et ré-indexation incrémentale
- Traitement en streaming et par lots
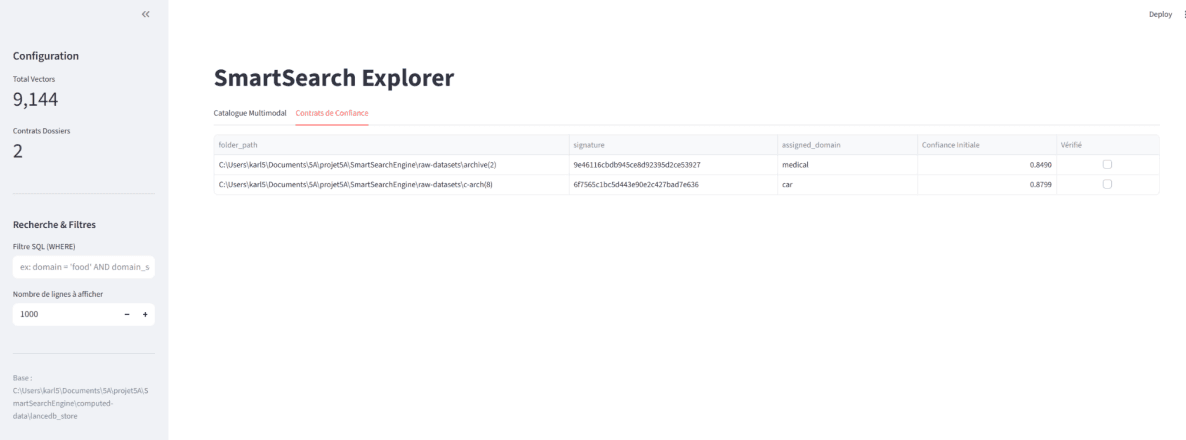
- Contrat de confiance et domaine assigné par dossier ingéré
05
IA locale et sobriété
Le LLM n’est pas appliqué systématiquement à chaque donnée. Mistral, exécuté localement via Ollama, intervient comme arbitre lorsque la structure ou la sémantique d’une source ne peut pas être déterminée de façon fiable par des règles simples. Pour les données structurées, le moteur analyse un échantillon afin de déterminer un plan de mapping, puis l’applique de manière déterministe au reste du fichier — une séparation qui réserve l’inférence générative aux étapes où elle apporte réellement de la valeur.
06
Recherche multimodale
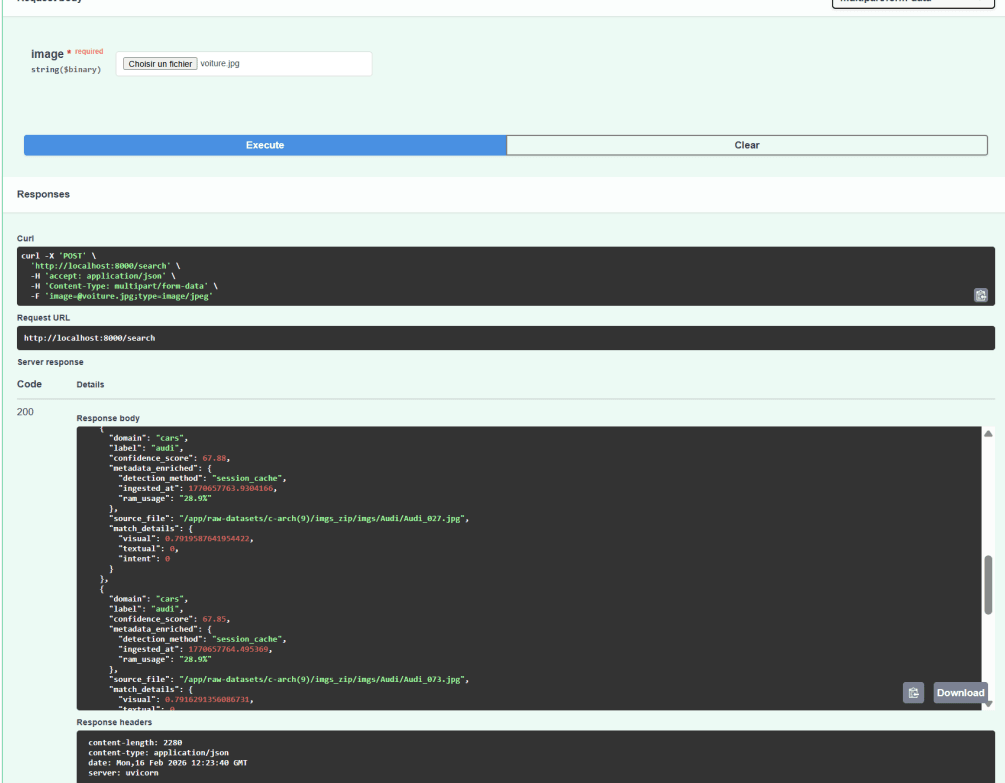
Une requête peut être analysée selon sa similarité visuelle, sa proximité sémantique entre image et texte, et son domaine ou intention estimée. Les résultats de ces différentes passes sont ensuite fusionnés, dédupliqués et classés à l’aide d’un score de confiance — une approche qui permet de traiter des requêtes visuelles ambiguës sans reposer sur une seule mesure de similarité.
07
Robustesse
Plusieurs mécanismes permettent au moteur de fonctionner au-delà d’un simple notebook de démonstration.
- Surveillance de l’utilisation mémoire et traitement par lots adaptatif
- Mise en pause automatique si les ressources deviennent trop contraintes
- Reprise des écritures en cas de verrouillage temporaire
- Validation de l’environnement avant le lancement du pipeline
- Déploiement conteneurisé reproductible
08
Validation
Le moteur a été évalué avec des scénarios d’ingestion massive et des tests de recherche, sur des jeux de données représentant plus de 20 Go de données hétérogènes et environ 100 000 images, complétés par des fichiers structurés et documentaires. Les essais ont couvert des environnements CPU et GPU.
- Consommation RAM / VRAM
- Temps d’ingestion et reprise d’un corpus déjà indexé sans retraitement complet
- Latence de recherche et pertinence des résultats
- Robustesse sur des requêtes absentes des jeux de données d’indexation
09
Chaîne de bout en bout
SmartSearch relie ingestion multimodale, stockage vectoriel, vision, traitement sémantique local, recherche hybride et restitution dans une même chaîne. Le projet se concentre moins sur l’interface finale que sur le socle technique permettant de transformer des données hétérogènes en résultats contextualisés, traçables et interrogeables localement.